Supervision de sécurité informatique : une alerte ne protège que si quelqu’un agit
La supervision de sécurité informatique consiste à détecter et qualifier les incidents sur un périmètre défini, puis à orienter la réaction appropriée. Elle associe des journaux techniques, des règles de détection et des analystes capables de distinguer une activité légitime d’une menace. Son efficacité dépend surtout d’un point : savoir qui intervient après l’alerte, avec quels moyens et dans quel délai.
Surveiller la sécurité, pas seulement la disponibilité
Un serveur peut fonctionner normalement tout en hébergeant une activité malveillante. À l’inverse, une application indisponible ne subit pas nécessairement une cyberattaque. La supervision informatique générale surveille principalement la disponibilité, les performances et les capacités. La supervision de sécurité recherche des signes de compromission : accès anormaux, utilisation abusive de privilèges ou communications suspectes.
Testez vos connaissances sur la supervision de sécurité
Répondez aux six questions, puis validez pour découvrir votre score et les explications.
Résultat
Notions à retenir :
- La supervision informatique suit le fonctionnement des systèmes ; la supervision de sécurité s’intéresse aux signaux de sécurité.
- Le SIEM rassemble et met en relation des informations ; le SOC en assure la surveillance et l’analyse opérationnelles.
- Un événement n’est pas automatiquement une alerte ni un incident : l’alerte doit être examinée et qualifiée.
- Une réponse efficace s’appuie sur des journaux exploitables et des responsabilités clairement coordonnées.
Les deux approches se complètent. Une hausse du trafic peut relever d’un succès commercial, d’un dysfonctionnement ou d’une attaque. C’est le rapprochement des événements avec le contexte métier et technique qui permet de trancher. Le terme monitoring désigne généralement cette activité de surveillance, sans préciser à lui seul son objectif.
Le SIEM centralise ; le SOC analyse et organise le traitement
Un SIEM centralise et corrèle les événements de sécurité issus de plusieurs équipements ou applications. Le SOC, ou centre opérationnel de sécurité, désigne l’organisation et les équipes qui surveillent, analysent et contribuent au traitement des alertes. Acheter un SIEM ne revient donc pas à disposer d’un SOC opérationnel.
Le guide de l’ANSSI situe la supervision dans un ensemble associant également le renseignement sur la menace et la réponse à incidents. La détection n’est qu’une partie de cette chaîne : elle doit déboucher sur une décision, puis sur des actions adaptées.
Choisir les données à surveiller selon les risques métier
Collecter tous les journaux sans objectif augmente les coûts et complique l’analyse. Il est préférable de partir des actifs critiques et des scénarios redoutés : compromission d’un compte administrateur, extraction de données sensibles ou propagation d’un logiciel malveillant. Chaque scénario doit être relié à des sources permettant de le détecter.
| Périmètre | Données utiles | Signaux à examiner |
|---|---|---|
| Identités et accès | Connexions, échecs d’authentification, changements de droits | Accès inhabituel, élévation de privilèges inattendue |
| Terminaux et serveurs | Journaux système, alertes antivirus et EDR | Exécution suspecte, désactivation d’une protection |
| Réseau | Flux, événements des pare-feu, accès distants | Communications inhabituelles, connexions interdites répétées |
| Applications et cloud | Accès aux données, actions d’administration, modifications de configuration | Export inhabituel, ouverture excessive des droits |
La qualité de cette télémétrie compte autant que son volume. Les horloges doivent être cohérentes, les événements compréhensibles et les sources disponibles. Une interruption de collecte constitue elle-même un signal à traiter : un tableau de bord sans alerte ne prouve rien si les journaux n’arrivent plus.
Ces données peuvent contenir des informations personnelles ou sensibles. Définissez leurs finalités, les accès autorisés, leur protection et leur durée de conservation selon les besoins d’investigation et les obligations applicables. La journalisation contribue à la traçabilité, mais ne garantit pas à elle seule la conformité au RGPD ou à ISO 27001.
Transformer une alerte en décision opérationnelle
Un événement est une observation technique ; une alerte signale une situation à examiner ; un incident correspond à une atteinte à la sécurité qui nécessite un traitement. Confondre ces niveaux conduit soit à mobiliser inutilement les équipes, soit à banaliser une menace réelle.
Guide ANSSI pour sécuriser l’interconnexion à Internet — Découvrez les recommandations officielles pour concevoir une passerelle Internet sécurisée avec zones réseau, pare-feu, DMZ, filtrage et journalisation.
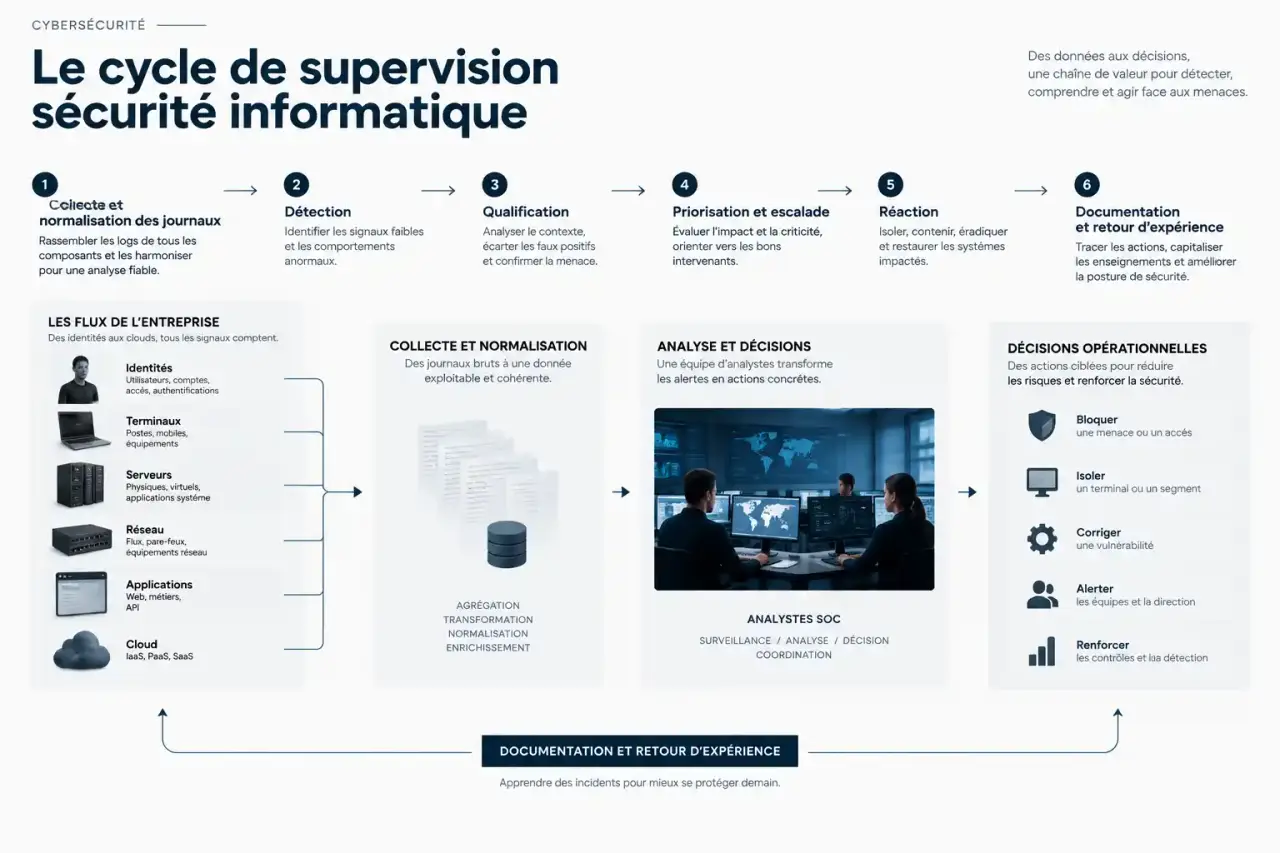
- Collecter et normaliser : rassembler les journaux et harmoniser leurs champs pour permettre les rapprochements.
- Détecter : appliquer des règles ou corréler plusieurs signaux pour faire émerger une activité suspecte.
- Qualifier : vérifier l’utilisateur, l’équipement, la chronologie et les explications légitimes possibles.
- Prioriser et escalader : apprécier la gravité selon les preuves, les actifs touchés et l’impact métier.
- Réagir et documenter : contenir la menace, organiser la remédiation et conserver la trace des décisions.
Exemple : une connexion inhabituelle suivie d’un changement de droits
Une connexion depuis un emplacement inhabituel ne suffit pas toujours à caractériser une attaque : un déplacement ou un accès distant peut l’expliquer. Si elle est suivie d’une attribution de droits administrateur puis d’un export de données, la corrélation justifie une investigation prioritaire. L’analyste vérifie notamment si ces opérations correspondent à une intervention autorisée.
Si la compromission est confirmée, la procédure peut prévoir la révocation des sessions, la suspension du compte ou l’isolement d’un poste. Ces actions doivent être autorisées et proportionnées : couper automatiquement un accès critique peut aussi interrompre l’activité. Le SOC analyse et recommande ; les intervenants habilités exécutent selon les responsabilités convenues.
Un runbook sert ici de béquille opérationnelle : il évite qu’une alerte dépende entièrement de la mémoire d’un expert. Mais il doit prévoir un relais si l’interlocuteur principal est absent, ainsi qu’une limite claire aux actions permises. Le test utile consiste à demander : « Si cette personne ne répond pas, qui peut décider et agir ? » Cette vérification révèle souvent une fragilité invisible dans les tableaux de bord.
Cadrer le projet et vérifier son efficacité réelle
Le projet doit commencer par une expression de besoin, et non par un catalogue d’outils. Le RSSI fixe les priorités de sécurité avec les métiers ; les équipes IT précisent les contraintes techniques ; les analystes construisent les détections et les procédures. Le guide de l’ANSSI fournit un cadre pour piloter ce travail et organiser des tests d’efficacité.
- Délimiter les actifs couverts et les exclusions connues.
- Associer chaque scénario prioritaire à des journaux et à une règle de détection.
- Définir les horaires de surveillance, les contacts et l’escalade hors horaires ouvrés.
- Préciser qui peut désactiver un compte, isoler un équipement ou interrompre un service.
- Tester le parcours complet, depuis l’événement jusqu’à l’intervention.
Suivez les délais de détection, de qualification et de prise en charge, mais aussi la disponibilité des sources et les alertes sans suite. Définissez précisément le début et la fin de chaque mesure : un délai de notification n’est pas un délai de résolution.
La fatigue d’alerte se réduit en corrigeant les règles trop bruyantes, pas en ignorant les notifications. À l’inverse, l’absence d’alertes peut masquer des faux négatifs. Des simulations contrôlées permettent de vérifier qu’un comportement attendu déclenche bien une alerte, puis une action.
SOC interne, externalisé ou Micro-SOC : comparer les engagements
Un SOC interne offre une maîtrise directe, mais nécessite des compétences, des remplacements et une organisation durable. L’externalisation apporte une expertise mutualisée ; elle laisse néanmoins à l’entreprise des responsabilités de décision et de remédiation. Un modèle hybride permet de répartir ces fonctions.
Le Micro-SOC est présenté notamment par Opsky comme une approche adaptée aux PME et ETI. Cette appellation ne définit pas un périmètre standard. Opsky annonce un déploiement en quelques semaines, contre plusieurs mois pour un SOC classique : cette comparaison reste à vérifier selon les intégrations et le service réellement retenu.
Pour comparer les offres, demandez les sources prises en charge, les exclusions, les horaires d’analyse et les délais contractuels. Une collecte continue ne signifie pas nécessairement une intervention humaine 24/7. Vérifiez également les pouvoirs de réponse, la confidentialité des journaux, leur restitution et les conditions de sortie.
Le bon choix est un dispositif capable de traiter vos scénarios critiques jusqu’à une action utile. Exigez une démonstration de cette chaîne complète plutôt qu’un simple écran affichant des alertes.